

La infraestructura de Benzinga está diseñada para una disponibilidad del 99,9%, lo que garantiza que tus aplicaciones reciban datos financieros confiables y en tiempo real en todo momento. Nuestro entorno de producción está exhaustivamente probado, completamente monitorizada y respaldado por soporte de ingeniería de guardia 24/5.
SLA de tiempo de actividad del 99,9 %
Confiabilidad probada en producción con redundancia multi-AZ
Monitoreo 24/7
Observabilidad en tiempo real con Coralogix y Datadog
Escalado automatizado
Despliegues sin tiempo de inactividad con escalado automático inteligente
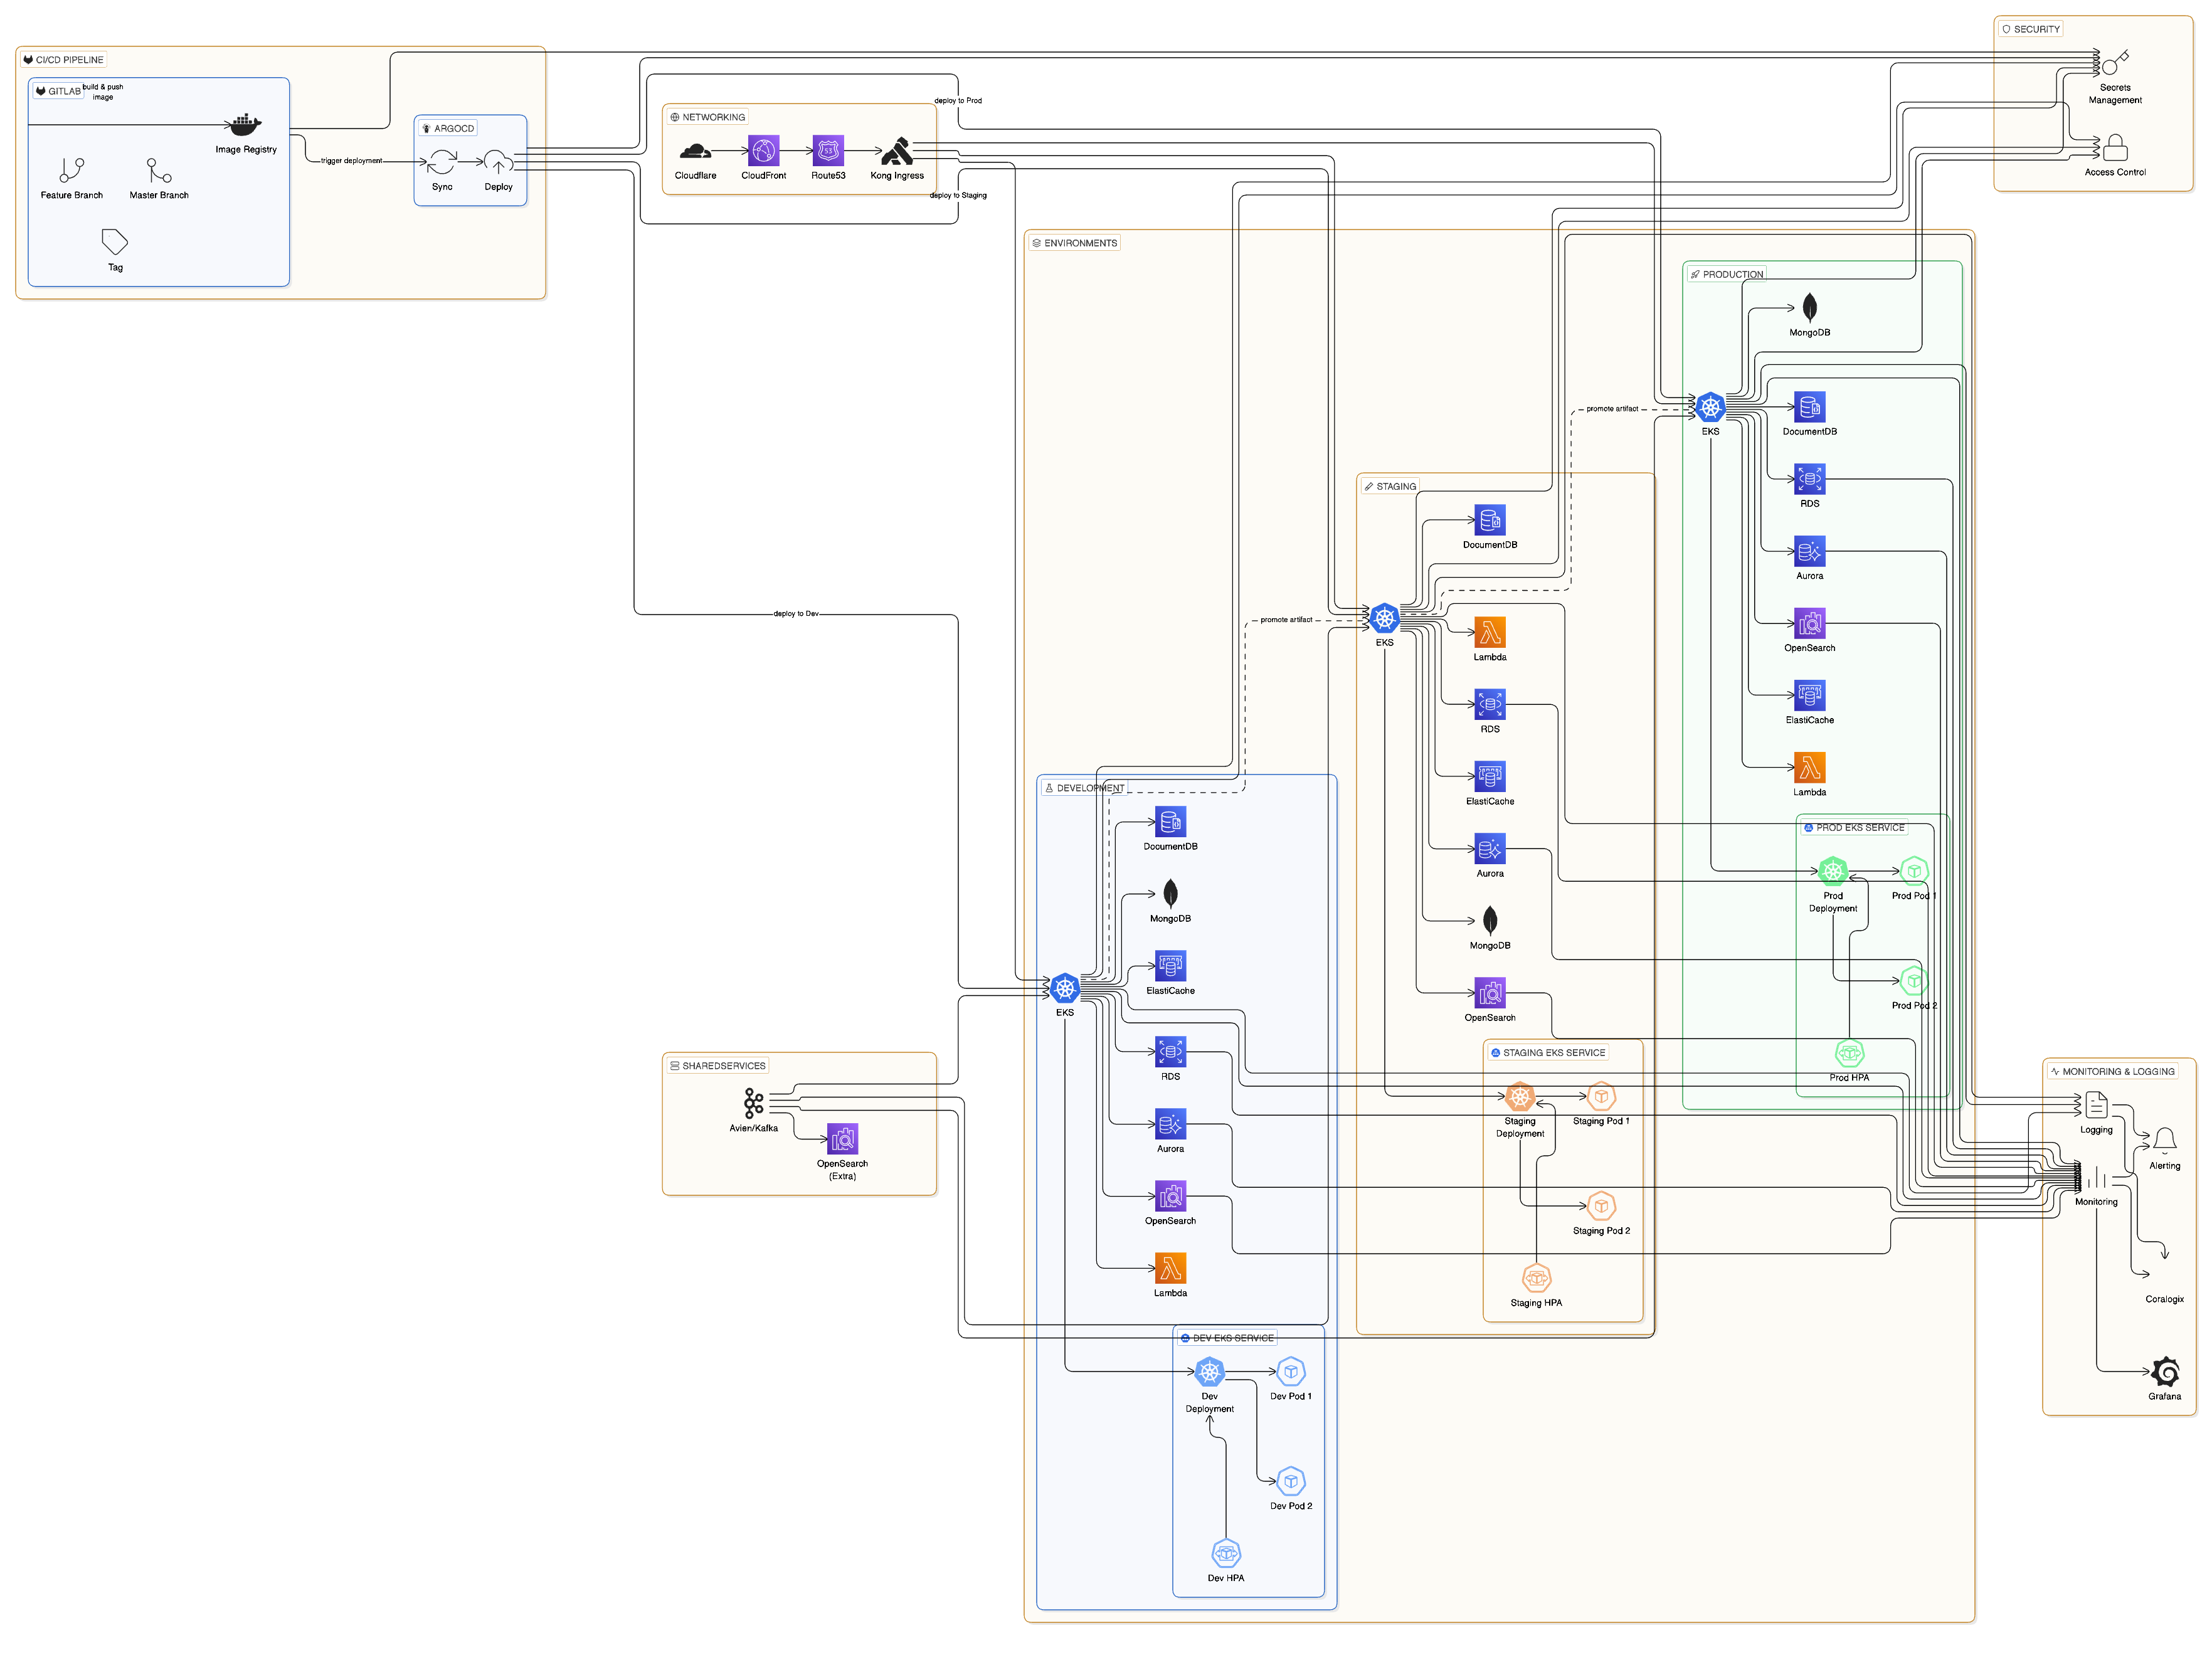
Nuestra infraestructura se ejecuta completamente en Amazon Web Services (AWS), aprovechando:
Implementación Multi-AZ
Servicios implementados en varias Zonas de Disponibilidad para tolerancia a fallos
AWS VPC
Una Virtual Private Cloud (VPC) aislada con políticas estrictas de grupos de seguridad
Route 53
DNS global con comprobaciones de estado y enrutamiento de conmutación por error automático
EKS administrado
Plano de control de Kubernetes administrado por AWS con un SLA del 99,95 %
- Karpenter — Autoescalador de nodos nativo de AWS que aprovisiona recursos de cómputo del tamaño adecuado en segundos, no minutos
- Horizontal Pod Autoscaler (HPA) — Escalado automático de pods basado en CPU, memoria y métricas personalizadas
- Kong Gateway — API gateway empresarial que gestiona tráfico de entrada/salida, limitación de solicitudes (rate limiting) y autenticación
- ArgoCD — Controlador de despliegue basado en GitOps para lanzamientos declarativos y auditables
Todo el tráfico de la API pasa a través de Kong Gateway, que proporciona:
1
Autenticación
Validación de claves de API y verificación de tokens JWT en el perímetro de la red
2
Limitación de tasa
Limitación de solicitudes por cliente para garantizar una asignación equitativa de recursos
3
Balanceo de carga
Distribución inteligente del tráfico entre pods de servicio en buen estado
4
Terminación SSL/TLS
Todo el tráfico se cifra con TLS 1.3; los certificados se renuevan automáticamente
- Enrutamiento global basado en latencia — Los usuarios son dirigidos automáticamente al endpoint más rápido
- Comprobaciones de estado (health checks) — Supervisión continua con conmutación por error automática en caso de fallo
- SLA de tiempo de actividad del 100% — Garantía de disponibilidad respaldada por AWS para la resolución DNS
Nuestro pipeline de despliegue aplica estrictos controles de calidad antes de que cualquier código llegue a producción.
Todos los despliegues se gestionan mediante ArgoCD, siguiendo los principios de GitOps:
- Declarativo — Estado deseado definido en Git, única fuente de verdad
- Sincronización automática — ArgoCD detecta cambios y los aplica automáticamente
- Capacidad de reversión — Reversión instantánea al deshacer commits de Git
- Registro de auditoría — Historial completo de despliegues mediante el registro de commits de Git
Nuestra infraestructura se escala automáticamente en varios niveles para manejar picos de tráfico. Cada despliegue de servicio incluye la configuración de Horizontal Pod Autoscaler:
- Uso de CPU > 70%
- Uso de memoria > 80%
- Métricas personalizadas (profundidad de la cola de solicitudes, percentiles de latencia)
- Aprovisiona nodos de tamaño óptimo en menos de 60 segundos
- Consolida nodos infrautilizados para reducir costos
- Admite instancias spot para cargas de trabajo no críticas
- Respeta la topología de pods y las restricciones de zona de disponibilidad
Nuestra infraestructura emplea monitorización a nivel empresarial con múltiples capas de observabilidad, lo que garantiza una visibilidad total del estado, el rendimiento y la fiabilidad del sistema. Cada componente se monitoriza de forma continua con alertas automatizadas y protocolos de respuesta a incidentes.
Coralogix
Trazas distribuidas y registros (logging)
- Agregación de registros en tiempo real de todos los servicios
- Trazas distribuidas a través de microservicios
- Monitoreo de rendimiento de aplicaciones (APM)
- Seguimiento de solicitudes de extremo a extremo con IDs de correlación
- Reconocimiento de patrones en los registros y detección de anomalías
- Paneles personalizados para métricas de negocio
Datadog
Alertas y monitoreo sintético
- Pruebas continuas 24/7 de endpoints de API
- Monitoreo sintético multirregión
- Seguimiento de tiempo de respuesta y disponibilidad
- Alertas automatizadas con enrutamiento inteligente
- Seguimiento de indicadores de nivel de servicio (SLI)
- Detección de regresiones de rendimiento
1
Registro centralizado
Todos los registros de las aplicaciones de cada servicio, pod y contenedor se agregan en tiempo real, lo que proporciona acceso instantáneo a la información de depuración en toda la infraestructura.
2
Rastreo distribuido
Cada solicitud de API se rastrea de extremo a extremo a través de microservicios, balanceadores de carga, bases de datos y servicios externos. Esto permite un análisis rápido de la causa raíz de problemas de rendimiento o errores.
3
Seguimiento de errores
Detección automática de errores con trazas de pila, información contextual y número de usuarios afectados. Los errores se categorizan por gravedad e impacto.
4
Análisis de rendimiento
Métricas en tiempo real sobre tiempos de respuesta de la API, rendimiento, tasas de error y utilización de recursos en todos los servicios.
- Política de retención: 30 días de almacenamiento en caliente para acceso inmediato, 90 días de archivo para cumplimiento normativo
- Rendimiento de consultas: Consultas en menos de un segundo sobre miles de millones de entradas de registro
- Integración de alertas: Enrutamiento automatizado a canales de Slack e ingenieros de guardia
- Paneles personalizados: Métricas específicas del negocio visibles para las partes interesadas en tiempo real
1
Pruebas sintéticas de API
Las pruebas automatizadas se ejecutan cada 60 segundos desde múltiples regiones geográficas, validando la disponibilidad de la API, los tiempos de respuesta y la precisión de los datos antes de que los clientes se vean afectados.
2
Alertas inteligentes
La detección de anomalías basada en aprendizaje automático identifica patrones inusuales en las métricas, activando alertas antes de que los problemas afecten a los clientes.
3
Supervisión de SLA
Seguimiento en tiempo real de los objetivos de nivel de servicio (SLO) con generación de informes automatizados sobre objetivos de disponibilidad del 99,9 %.
4
Comparación de rendimiento
Monitorización continua de los percentiles de latencia p50, p95 y p99 para garantizar un rendimiento constante.
Todos los sistemas de monitorización se integran con canales dedicados de Slack para visibilidad inmediata y respuesta rápida:
#alerts-production
Alertas críticas
- Incidentes P1/P2 que requieren acción inmediata
- Alertado automático del ingeniero de guardia
- Métricas en tiempo real y enlaces a runbooks
- Asignación de un responsable del incidente
#monitoring-insights
Información de rendimiento
- Resúmenes diarios del estado
- Alertas de planificación de capacidad
- Notificaciones de tendencias de rendimiento
- Advertencias de detección de anomalías
- Alerta activada → Notificación automática en Slack con contexto y métricas
- Ingeniero de guardia realiza el triage → Se evalúa la gravedad y se crea el canal de incidentes
- Desarrollador asignado → Se etiqueta a la persona experta en el tema según el servicio afectado
- Investigación → Análisis de causa raíz usando trazas de Coralogix y métricas de Datadog
- Resolución → Corrección desplegada mediante el pipeline estándar de GitOps
- Análisis post mortem → Incidente documentado con medidas preventivas
- Aislamiento de VPC — Segmentación completa de la red respecto de la Internet pública
- Security Groups — Reglas estrictas de entrada/salida, con denegación por defecto
- TLS en todas partes — Todo el tráfico interno y externo cifrado
- Gestión de secretos — AWS Secrets Manager para credenciales confidenciales
- RBAC — Control de acceso basado en roles (RBAC) de Kubernetes para todas las operaciones
- Integración SSO — Integración con el proveedor de identidad empresarial (SSO)
- Registros de auditoría — Registros de acceso completos conservados para fines de cumplimiento normativo
- Replicación Multi-AZ — Datos replicados entre zonas de disponibilidad
- Conmutación por error automatizada — Las comprobaciones de estado de Route 53 activan la conmutación por error de DNS
- Despliegues progresivos — Despliegues sin tiempo de inactividad con reversión automática
- Copia de seguridad y restauración — Copias de seguridad diarias automatizadas con recuperación a un punto en el tiempo
La infraestructura de Benzinga está probada en producción a gran escala, gestionando millones de solicitudes diarias con fiabilidad demostrada:
Probada a gran escala
Estadísticas de producción
- Más de 10 millones de solicitudes de API procesadas diariamente
- Tiempo de respuesta medio inferior a 100 ms
- 99,9 % de disponibilidad histórica
- Sin pérdida de datos en más de 3 años
Operaciones de nivel empresarial
Excelencia operativa
- Cobertura de ingeniería on-call 24/5/365
- Conmutación por error automatizada y autorrecuperación
- Redundancia multirregión
1
Visibilidad completa
Cada solicitud, entrada de log y métrica se sigue de extremo a extremo usando trazas distribuidas de Coralogix y registros centralizados
2
Detección proactiva
El monitoreo sintético de Datadog prueba las APIs cada 60 segundos desde múltiples regiones, y alerta sobre problemas antes de que afecten a los clientes
3
Respuesta rápida
La integración automatizada con Slack enruta las alertas a canales dedicados con asignación inmediata de desarrolladores y seguimiento de la resolución
4
Mejora continua
El análisis postmortem de todos los incidentes garantiza que los problemas no vuelvan a ocurrir, con medidas preventivas automatizadas
Listo para producción: Nuestra infraestructura ha procesado más de mil millones de solicitudes de API con un 99,9% de disponibilidad y mantiene una latencia inferior a 100 ms para la entrega de datos financieros en tiempo real.
La infraestructura de Benzinga ofrece fiabilidad a nivel empresarial mediante:
1
Arquitectura Nativa en la Nube
AWS EKS con implementación multi-AZ y plano de control gestionado que garantiza el máximo tiempo de actividad
2
Implementaciones GitOps
Despliegues gestionados con ArgoCD, con registro de auditoría completo y capacidades de reversión inmediata
3
Autoescalado Inteligente
Karpenter + HPA para una gestión de capacidad transparente que maneja automáticamente los picos de tráfico
4
Supervisión de Clase Mundial
Trazado/registro con Coralogix + alertas/pruebas sintéticas con Datadog e integración con Slack para una respuesta rápida ante incidentes
5
Operaciones 24/5
Ingenieros dedicados de guardia
6
Seguridad Rigurosa
Defensa en profundidad con cifrado, RBAC y aislamiento de red para proteger sus datos
Su éxito es nuestra prioridad: Si tiene preguntas sobre nuestra infraestructura, las garantías de SLA o desea hablar de sus requisitos específicos de fiabilidad, póngase en contacto con su representante de cuenta o envíe un correo electrónico a support@benzinga.com.