

Benzinga のインフラは 99.9% の可用性 を実現するよう設計されており、アプリケーションが常時、信頼性の高いリアルタイム金融データを受信できるようになっています。本番環境は実運用で実証されており、全面的に監視され、平日24時間(24/5)のオンコールエンジニアリングサポートによって支えられています。
99.9% 稼働率 SLA
マルチ AZ 冗長構成による本番環境で実証された高い信頼性
24時間365日の監視
Coralogix および Datadog によるリアルタイムな可観測性
自動スケーリング
インテリジェントなオートスケーリングによるゼロダウンタイムのデプロイ
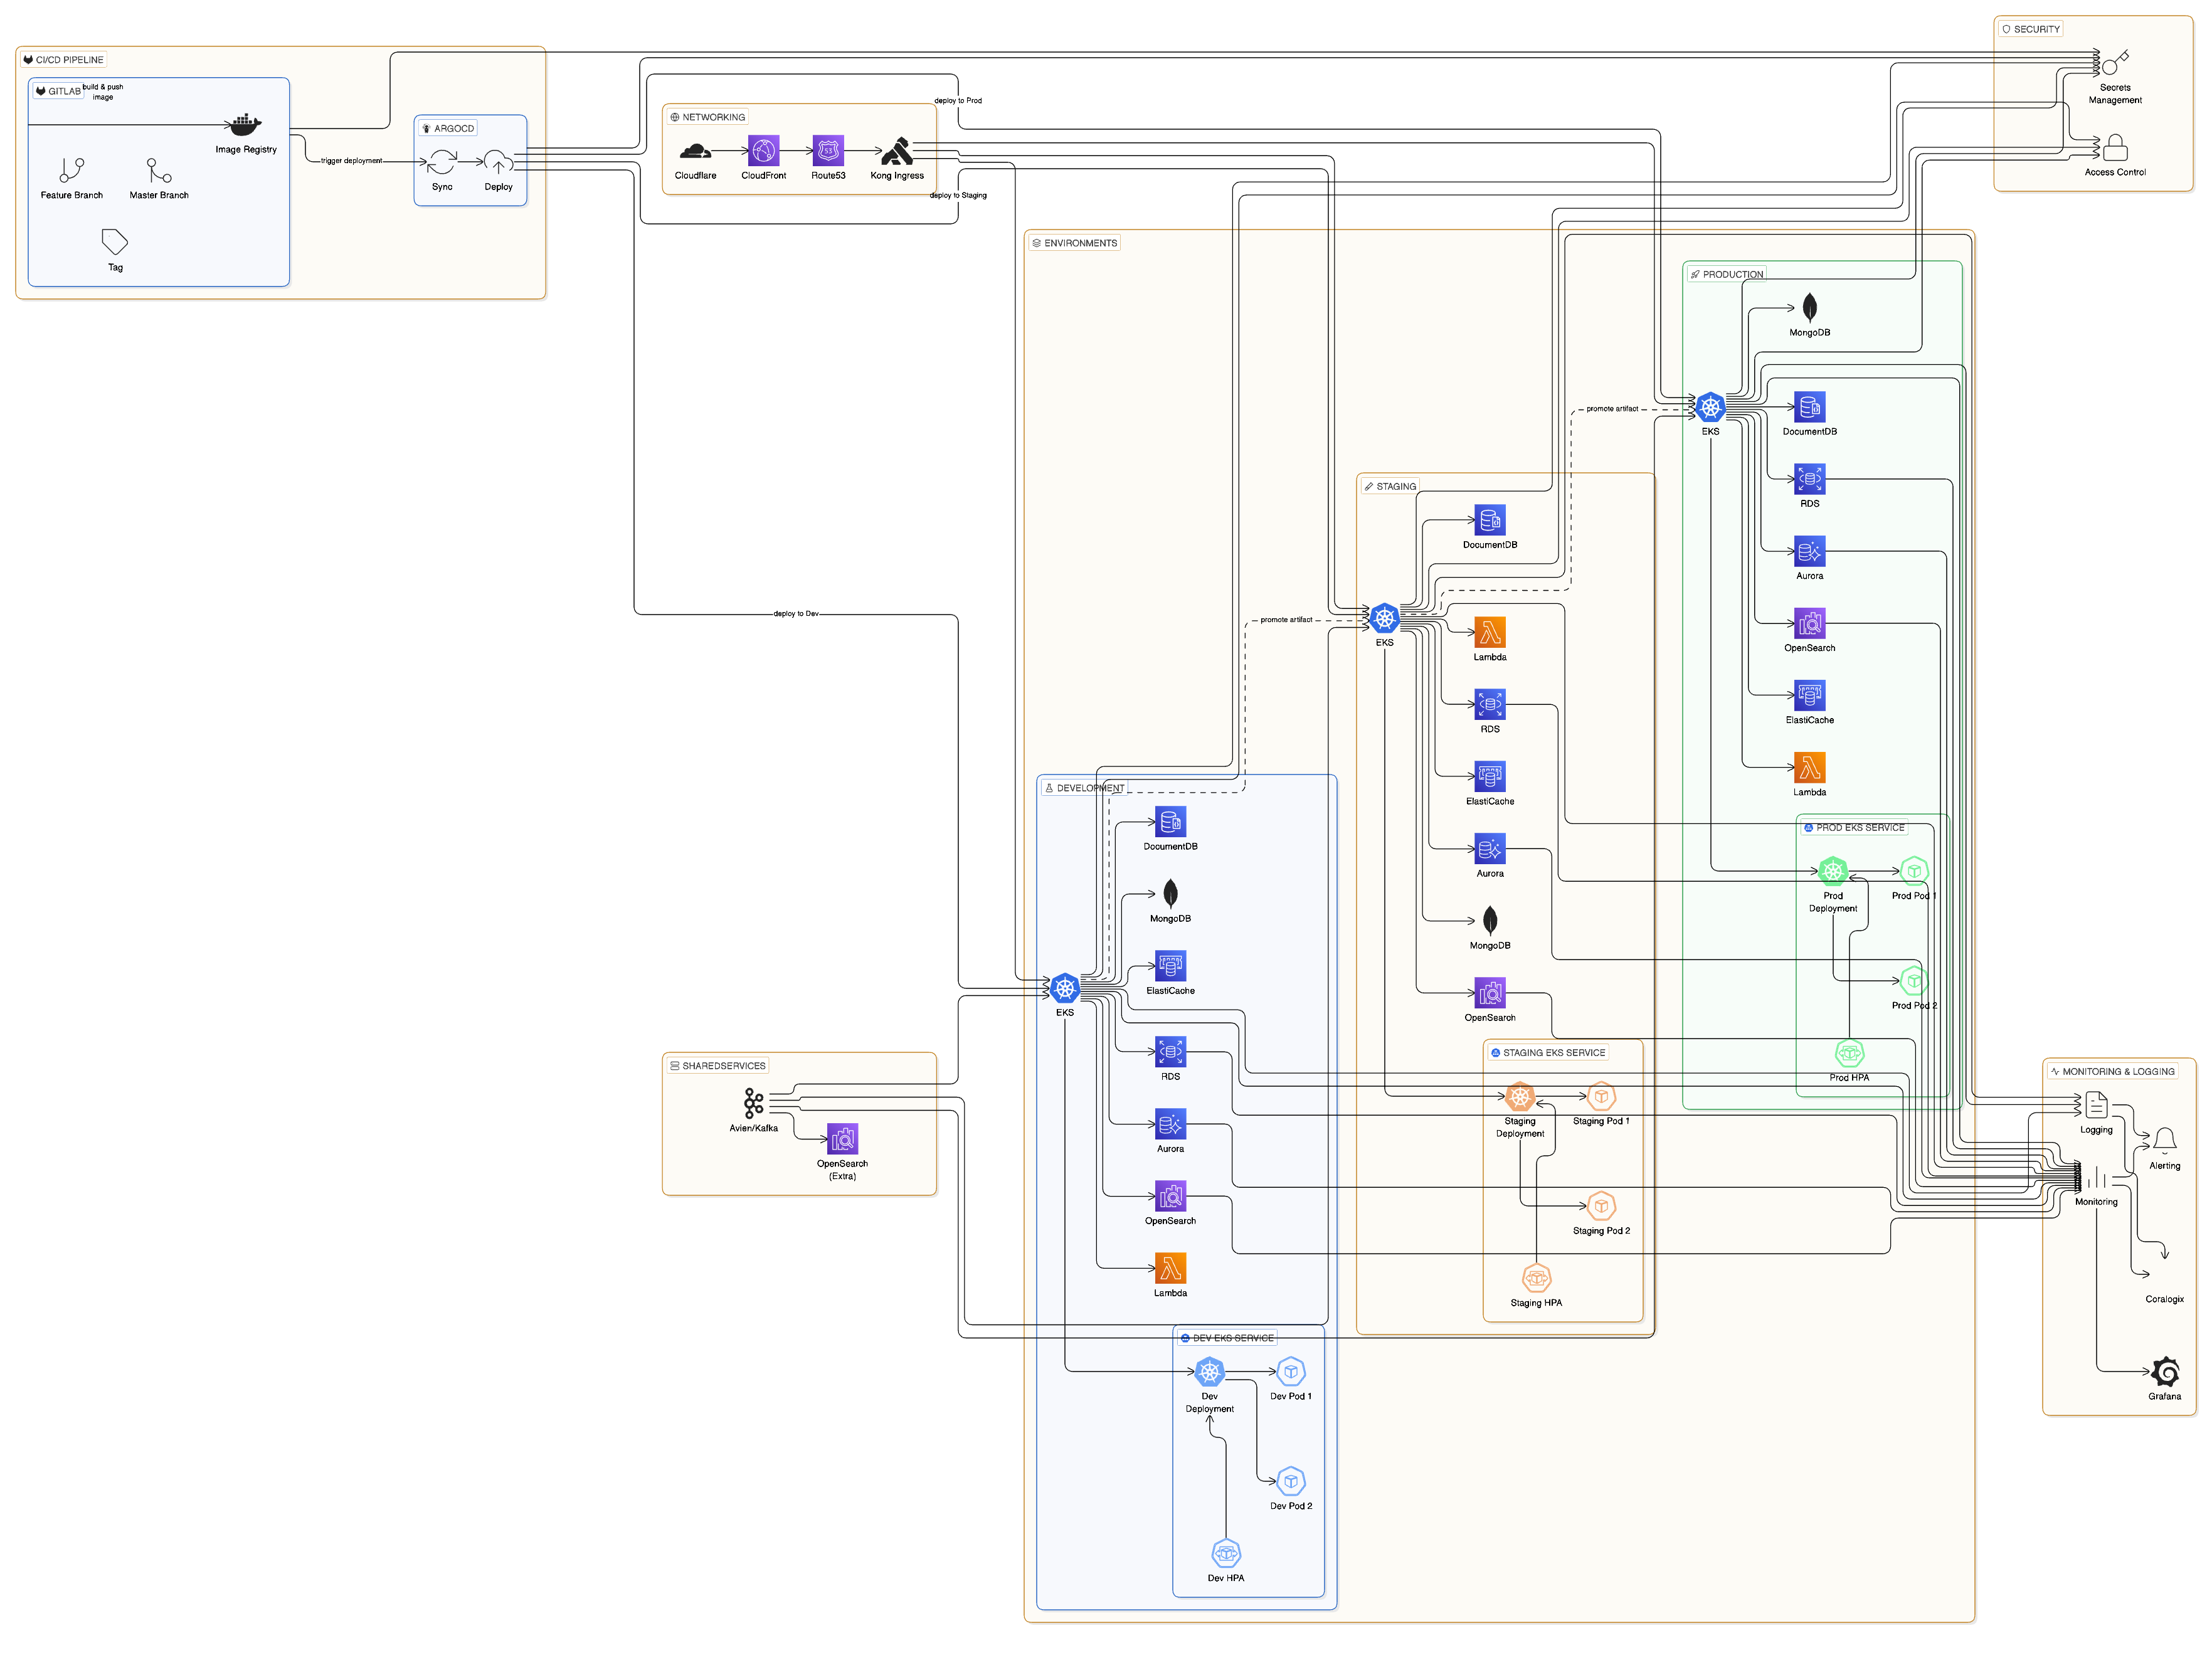
当社のインフラストラクチャはすべて Amazon Web Services (AWS) 上で稼働しており、次の機能を活用しています:
マルチ AZ デプロイ
フォールトトレランスを確保するため、複数のアベイラビリティーゾーンに分散配置されたサービス
AWS VPC
厳格なセキュリティグループポリシーを適用した分離された Virtual Private Cloud (VPC)
Route 53
ヘルスチェックと自動フェイルオーバー・ルーティング機能を備えたグローバル DNS
マネージド EKS
AWS 管理の Kubernetes コントロールプレーンによる 99.95% の SLA
- Karpenter — 数分単位ではなく数秒で適切なサイズのコンピュートリソースをプロビジョニングする、AWS ネイティブなノード・オートスケーラー
- Horizontal Pod Autoscaler (HPA) — CPU、メモリ、およびカスタムメトリクスに基づいて Pod を自動的にスケーリング
- Kong Gateway — ingress/egress、レート制限、認証を処理するエンタープライズ向け API ゲートウェイ
- ArgoCD — 宣言的で監査可能なリリースを実現する、GitOps ベースのデプロイメントコントローラー
すべてのAPIトラフィックは Kong Gateway を通過し、次の機能を提供します:
1
認証
エッジ側でのAPIキー検証およびJWTトークンの検証
2
レート制限
公平なリソース配分を保証するためのクライアントごとのリクエスト制限
3
負荷分散
正常に稼働しているサービスポッド間でのインテリジェントなトラフィック分散
4
SSL/TLS終端
すべてのトラフィックをTLS 1.3で暗号化し、証明書を自動更新
- グローバルなレイテンシベースのルーティング — ユーザーを自動的に最速のエンドポイントにルーティング
- ヘルスチェック — 障害発生時の自動フェイルオーバーを伴う継続的な監視
- 100% 稼働 SLA — DNS 解決に対する AWS による可用性保証
デプロイパイプラインでは、本番環境にコードをリリースする前に厳格な品質ゲートを設けています。
すべてのデプロイは、GitOps の原則に従い ArgoCD によって管理されます:
- 宣言的 — 望ましい状態を Git 上で定義し、単一の信頼できる情報源とする
- 自動同期 — ArgoCD が変更を検知して自動的に適用する
- ロールバック機能 — Git コミットを戻すことで即時にロールバック可能
- 監査証跡 — Git のコミットログによる完全なデプロイ履歴
当社のインフラストラクチャは、トラフィックの急増に対応するため、複数のレベルで自動的にスケールします。 各サービスのデプロイには、Horizontal Pod Autoscaler (HPA) の設定が含まれています。
- CPU 使用率 > 70%
- メモリ使用率 > 80%
- カスタムメトリクス(リクエストキュー長、レイテンシーのパーセンタイル値)
- 60秒以内に最適なサイズのノードをプロビジョニングする
- 活用率の低いノードを集約してコストを削減する
- 重要度の低いワークロード向けにスポットインスタンスをサポートする
- Pod のトポロジーおよびアベイラビリティゾーンの制約を考慮する
当社のインフラストラクチャは、多層的なオブザーバビリティを備えたエンタープライズグレードのモニタリングを採用しており、システムの健全性、パフォーマンス、信頼性を完全に可視化できるようにしています。すべてのコンポーネントは、自動アラートとインシデント対応プロセスにより継続的に監視されています。
Coralogix
分散トレーシングとログ監視
- すべてのサービスからのリアルタイムなログ集約
- マイクロサービス間の分散トレーシング
- アプリケーション性能監視(APM)
- 相関IDを用いたエンドツーエンドのリクエスト追跡
- ログパターンの認識と異常検知
- ビジネスメトリクス向けのカスタムダッシュボード
Datadog
アラートとシンセティックモニタリング
- 24時間365日の継続的なAPIエンドポイントテスト
- 複数リージョンでのシンセティックモニタリング
- レスポンスタイムと可用性の監視
- インテリジェントなルーティングによる自動アラート
- サービスレベル指標(SLI)の追跡
- パフォーマンス劣化の検知
1
集中ログ管理
すべてのサービス、Pod、およびコンテナからのアプリケーションログをリアルタイムに集約し、インフラ全体にわたるデバッグ情報へ即時にアクセス可能にします。
2
分散トレーシング
すべての API リクエストを、マイクロサービス、ロードバランサー、データベース、および外部サービスにまたがってエンドツーエンドでトレースします。これにより、パフォーマンス問題やエラーの根本原因を迅速に分析できます。
3
エラー追跡
スタックトレース、コンテキスト情報、影響を受けたユーザー数を含む自動エラー検出を行います。エラーは重大度と影響度に基づいて分類されます。
4
パフォーマンス分析
すべてのサービスにわたる API レスポンスタイム、スループット、エラー率、およびリソース使用率に関するリアルタイムのメトリクスを提供します。
- 保持ポリシー: 即時アクセス用の 30 日間ホットストレージと、コンプライアンス対応のための 90 日間アーカイブ
- クエリパフォーマンス: 数十億件のログエントリに対してサブ秒レイテンシでのクエリ
- アラート連携: Slack チャンネルおよびオンコールエンジニアへの自動ルーティング
- カスタムダッシュボード: ビジネス固有のメトリクスをステークホルダーがリアルタイムに閲覧可能
1
Synthetic API Testing
自動テストが複数の地理的リージョンから 60 秒ごとに実行され、顧客に影響が出る前に API の可用性、レスポンスタイム、データの正確性を検証します。
2
Intelligent Alerting
機械学習による異常検知がメトリクスにおける異常なパターンを特定し、問題が顧客に影響を与える前にアラートを発報します。
3
SLA Monitoring
サービスレベル目標 (SLO) をリアルタイムで監視し、99.9% の可用性目標に対する自動レポートを生成します。
4
Performance Benchmarking
p50、p95、p99 レイテンシーのパーセンタイルを継続的に監視し、一貫したパフォーマンスを確保します。
すべての監視システムは、即時の可視性と迅速な対応のために、専用の Slack チャンネル と連携しています:
#alerts-production
クリティカルアラート
- 即時対応が必要な P1/P2 インシデント
- オンコールエンジニアへの自動ページング
- リアルタイムメトリクスとランブックへのリンク
- インシデントコマンダーの割り当て
#monitoring-insights
パフォーマンスインサイト
- 日次ヘルス状況サマリー
- キャパシティプランニング用アラート
- パフォーマンストレンド通知
- 異常検知の警告
- アラート検知 → コンテキストとメトリクス付きの自動 Slack 通知
- オンコールエンジニアによるトリアージ → 重大度を評価し、インシデント用チャンネルを作成
- 開発者アサイン → 影響を受けたサービスに基づき、担当の専門エンジニアをタグ付け
- 調査 → Coralogix のトレースと Datadog のメトリクスを用いた根本原因分析
- 解決 → 標準的な GitOps パイプラインを通じて修正をデプロイ
- ポストモーテム → インシデントを文書化し、再発防止策を定義
- VPC 分離 — パブリックインターネットからの完全なネットワーク分離
- セキュリティグループ — 厳格なインバウンド/アウトバウンドルール、デフォルト拒否ポリシー
- TLS の徹底適用 — すべての内部・外部トラフィックを暗号化
- シークレット管理 — 機密性の高い認証情報を AWS Secrets Manager で管理
- RBAC — すべての操作に対する Kubernetes ロールベースのアクセス制御
- SSO 統合 — エンタープライズ向け ID プロバイダーとの統合
- 監査ログ — コンプライアンス対応のために保持される完全なアクセスログ
- マルチ AZ レプリケーション — 可用性ゾーン間でのデータ複製
- 自動フェイルオーバー — Route 53 のヘルスチェックによって DNS フェイルオーバーを実行
- ローリングデプロイ — ゼロダウンタイムでのデプロイと自動ロールバック
- バックアップとリストア — ポイントインタイムリカバリ対応の自動日次バックアップ
Benzinga のインフラは、大規模な本番環境で検証済みであり、実運用で日次数百万件のリクエストを高い信頼性で処理しています。
大規模環境での実戦投入実績
本番環境での実績
- 1,000 万件超の API リクエストを日次処理
- 平均レスポンスタイム 100ms 未満
- 稼働率 99.9% を達成
- 3 年超にわたりデータ損失ゼロ
エンタープライズグレードの運用
運用面での卓越性
- 24/5/365 のオンコールエンジニア体制
- 自動フェイルオーバーとセルフヒーリング
- 複数リージョンによる冗長構成
1
完全な可視性
すべてのリクエスト、ログエントリ、メトリクスを、Coralogix の分散トレーシングと集中ログ管理を用いてエンドツーエンドで追跡します
2
プロアクティブな検知
Datadog のシンセティックモニタリングにより、複数リージョンから 60 秒ごとに API をテストし、お客様への影響が出る前に問題をアラートします
3
迅速な対応
自動化された Slack 連携により、アラートを専用チャンネルへルーティングし、開発者の即時アサインと解決状況のトラッキングを行います
4
継続的な改善
すべてのインシデントに対してポストモーテム分析を行い、自動化された予防措置によって問題が再発しないようにします
本番運用対応: 当社のインフラストラクチャは、可用性 99.9% を維持しつつ、リアルタイム金融データ配信で 100ms 未満のレイテンシを保ちながら、これまでに 数十億件の API リクエスト を処理してきました。
Benzinga のインフラストラクチャは、次の要素により エンタープライズグレードの信頼性 を提供します。
1
クラウドネイティブアーキテクチャ
AWS EKS を用いたマルチ AZ デプロイとマネージドコントロールプレーンにより、最大限の稼働時間を確保します
2
GitOps デプロイメント
ArgoCD によるリリース管理で、完全な監査証跡と即時ロールバック機能を提供します
3
インテリジェントなオートスケーリング
Karpenter と HPA によるシームレスなキャパシティ管理で、トラフィックのスパイクを自動的に処理します
4
世界水準のモニタリング
Coralogix によるトレース/ログと Datadog によるアラート/シンセティクス、さらに Slack 連携により、迅速なインシデント対応を実現します
5
24/5 オペレーション体制
専任のオンコールエンジニアが対応にあたります
6
厳格なセキュリティ
暗号化、RBAC、ネットワーク分離による多層防御で、お客様のデータを保護します
お客様の成功が最優先です: インフラストラクチャ、SLA 保証、またはお客様固有の信頼性要件についてご質問やご相談がある場合は、アカウント担当者までお問い合わせいただくか、support@benzinga.com までメールでご連絡ください。